
Comment les agents IA réduisent d’environ 25% les tâches manuelles de notre support
- Publié le
- 4 min reading
Chez Comarch, le support traite un nombre élevé de tickets, environ 110 000 par an sur des centaines de projets maintenus et plusieurs lignes de produits intégrées. Ce volume, combiné à une grande diversité de domaines métiers et de clients, rend le traitement manuel lent, irrégulier et difficile à faire évoluer sans augmenter les effectifs. Plutôt que de chercher à s'accommoder d’une solution d'automatisation générique, nous avons choisi de décomposer l'ensemble du périmètre du support en catégories, de faire correspondre chacune d'elles à sa procédure de traitement existante, puis de construire sur cette base un modèle d'agents IA en deux phases – une approche qui a permis de réduire le temps de traitement global d'environ 20 à 25 %.
Dans cet article :
- Pourquoi une approche d'automatisation générique et unique ne fonctionne pas pour notre support.
- La méthode en quatre étapes pour transformer plus de 150 catégories de tickets en une feuille de route d'automatisation réaliste.
- Comment un modèle d'agents IA en deux phases route et résout les tickets sans sacrifier la précision.
En quoi le support Comarch est si particulier
Ce qui rend notre support de premier niveau spécifique, ce n'est pas seulement le volume, mais la diversité. Le support couvre plusieurs lignes de produits intégrées – e-invoicing, EDI, ECM, OD et SFA – et prend en charge de nombreux projets de maintenance. Cette diversité de domaines métiers et de clients se traduit directement par une forte fragmentation des projets, qui entraîne à son tour un grand nombre de procédures de traitement très spécifiques. Un ticket concernant une erreur de transmission de document ne suit pas du tout le même chemin qu'une demande d'onboarding partenaire ou qu'un changement de certificat AS2.
Cette diversité constitue le cœur du problème pour l'automatisation. Le support reçoit chaque année plus de 150 catégories de tickets distinctes. Les trier manuellement est, par nature, lent et irrégulier, et un ticket mal orienté peut faire perdre des heures avant d'atteindre le spécialiste réellement en mesure de le résoudre. Toute démarche d'automatisation doit donc commencer par donner du sens à cette complexité – c'est exactement ce que nous avons fait chez Comarch.
Comment nous avons abordé l'automatisation de notre support
1. Choisir quoi automatiser
Transformer cette complexité en plan d'action concret a nécessité une méthode structurée en quatre étapes :
- Identifier les catégories : plus de 150 catégories de tickets ont été identifiées, chacune propre à un besoin différent.
- Construire des modèles : les catégories à fort volume – celles générant plus de 1 000 tickets par an – ont été découpées en modèles de tickets reflétant leur structure et leur contenu type.
- Faire correspondre aux procédures : chaque type de ticket a été classé et associé à sa procédure de traitement spécifique existante.
- Évaluer le potentiel d'automatisation : chaque procédure de traitement a ensuite été évaluée individuellement selon son potentiel d'automatisation.
Cette vision structurée, priorisant le volume, a permis de construire une feuille de route d'automatisation réaliste – ciblant en premier les catégories générant le plus d'effort manuel, plutôt que d'automatiser ce qui se présentait comme le plus simple.
2. Le modèle d'automatisation : un traitement en deux phases
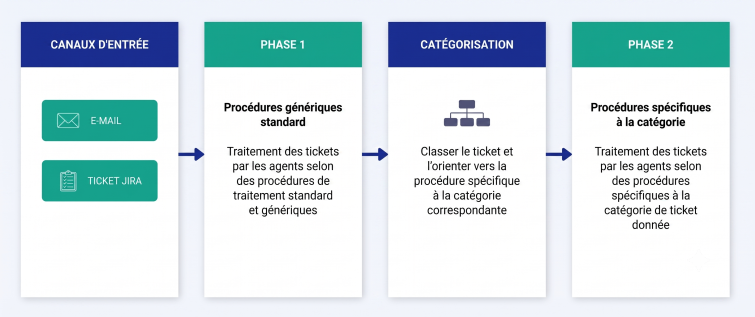
L'automatisation elle-même suit un modèle en deux phases, déclenché par l'arrivée des tickets via e-mail ou Jira.
- Phase 1 – procédures génériques : chaque nouveau ticket est d'abord pris en charge par un agent appliquant des procédures de traitement standard et génériques, valables quelle que soit la catégorie.
- Catégorisation : une fois la phase 1 terminée, le ticket est classé et orienté vers la procédure de traitement correspondant à sa catégorie spécifique.
- Phase 2 – procédures spécifiques à la catégorie : un agent dédié prend alors le relais, en suivant la procédure conçue spécifiquement pour cette catégorie de ticket.
Sur le plan technique, le flux est simple. Les tickets sont créés dans Jira et récupérés par un composant récepteur qui lit les nouveaux tickets. Des règles métier valident et orientent chaque ticket, en s'appuyant sur un utilitaire partagé de lecture de documents lorsque du contenu XML ou des certificats doivent être analysés. Un assistant IA classe ensuite le ticket et rédige une réponse, en s'appuyant sur une base de connaissances pour la reconnaissance de schémas ainsi que sur les sources de données clients et EDI pertinentes pour fournir les éléments factuels nécessaires. Certains agents IA rédigent la réponse finale directement dans le ticket Jira d'origine, ce qui centralise l'échange pour le client comme pour l'équipe du support, tandis que d'autres prennent en charge l'ensemble du processus et résolvent le ticket de bout en bout.
Comment les agents IA appuient le support
Plusieurs agents IA construits sur ce modèle sont déjà en production, chacun ciblant une part spécifique et à fort volume du travail du support. Les six plus importants sont :
- Ticket Categorizer - attribue à chaque nouveau ticket la bonne catégorie et sous-catégorie, en se basant sur le résumé, la description et les fichiers XML joints, afin qu'il parvienne dès la première minute à l'équipe spécialisée compétente.
- Document Status Verifier - récupère les logs et statuts des documents EDI pour diagnostiquer les erreurs de validation ou de traitement.
- Partner Data Retriever - recherche la configuration technique d'un partenaire B2B – routage, canaux, certificats – à partir d'un simple GLN/ILN mentionné dans le ticket.
- Fazer Error Handler - classe les incidents récurrents de transmission de documents selon des schémas d'erreurs connus et rédige la réponse au client.
- AS2 Certificate Handler - vérifie et prépare les demandes de changement de certificat AS2 afin qu'elles parviennent à l'équipe de deuxième niveau prêtes à être traitées, sans aller-retours pour des données manquantes.
- Similar Issues Finder - joint à chaque nouveau ticket des liens vers les tickets antérieurs les plus similaires, donnant instantanément au personnel du service desk du contexte et des solutions déjà connues.
Comment ces agents IA fonctionnent-ils concrètement ?
Chacun de ces agents génère un gain de temps important sur les processus courants du support. Voici à quoi cela ressemble en pratique, à travers l'exemple du Document Status Verifier et du Similar Issues Finder.
Auparavant, les équipes du support consacraient environ trois minutes par ticket à rechercher manuellement les traces de documents, les statuts et les erreurs de validation dans notre outil interne, EDI Tracking, avant de pouvoir répondre à un client. L'agent Document Status Verifier identifie désormais l'ID de message ou le numéro de document dans le ticket, interroge EDI Tracking pour obtenir l'historique complet des événements, puis publie directement un résultat prêt à l'emploi sous forme de commentaire dans Jira.
De son côté, Similar Issues Finder intègre le contenu de chaque nouveau ticket et interroge une base de données vectorielle pour identifier les quatre tickets antérieurs les plus similaires au-delà d'un seuil de similarité défini, puis publie cette liste en commentaire Jira, permettant au technicien de voir immédiatement comment des cas similaires ont été résolus, sans avoir à les rechercher manuellement.
Les résultats de l'automatisation de notre support
- Sur la base des volumes de tickets 2025, les agents déjà en production permettraient d'économiser près de 6 000 heures de travail manuel par an – soit l'équivalent d'environ trois équivalents temps plein (ETP).
- Une réduction moyenne du temps de traitement d'environ 20 à 25 %.
- Environ 8,8 % des tickets sont désormais automatisés de bout en bout, sans intervention manuelle.
Un modèle conçu pour évoluer
Le principal levier ici n'a pas été un outil d'automatisation unique et puissant : c'est la discipline consistant à faire correspondre les catégories de tickets aux procédures avant même de construire le premier agent. Cette approche structurée et pilotée par les volumes a transformé un ensemble complexe de plus de 150 catégories en une feuille de route réaliste et priorisée.
Ce qui rend ce modèle en deux phases puissant, c'est qu'il est pensé pour évoluer en permanence. Nous continuons à l'enrichir de nouveaux agents – leur nombre en production dépasse désormais largement la dizaine. Chaque nouvel agent se traduit par une baisse des coûts, une résolution plus rapide et un traitement plus cohérent pour nos clients – avec encore une importante marge de progression sur ces trois plans.
Wojciech Nowak
Head of AI LAB chez Comarch E-Invoicing